본문 바로가기 주메뉴 바로가기
국회도서관 홈으로 정보검색 소장정보 검색

결과 내 검색

동의어 포함

목차보기


제1부 자료구조 알고리즘 이해9
1. 자료구조 알고리즘 개요10
2. 링크드 리스트(LINKED LIST)15
2.1 주소(포인터)연산 이해15
2.2 링크드 리스트 전체소스19
2.3 LIST_ADD (STACK)32
2.4 LIST_ADD_TAIL (QUEUE)39
3. 큐(QUEUE)45
4. RED-BLACK TREE59
4.1 RED-BLACK TREE 개념59
4.2 RED-BLACK TREE 소스64
4.2.1 include/linux/rbtree.h64
4.2.2 lib/rbtree.c67
4.2.3 rbtree_test.c78
4.2.4 실행 결과83
4.3 RED-BLACK TREE 구조체87
4.4 삽입(INSERT) 소스1 분석90
4.4.1 노드(key=10) 삽입91
4.4.2 노드(key=20) 삽입94
4.4.3 노드(key=30) 삽입97
4.4.4 노드(key=40) 삽입103
4.4.5 노드(key=50) 삽입106
4.4.6 노드(key=60) 삽입109
4.4.7 노드(key=70) 삽입111
4.4.8 노드(key=80) 삽입114
4.5 삽입(INSERT) 소스2 분석120
4.5.1 노드(key=80) 삽입121
4.5.2 노드(key=70) 삽입124
4.5.3 노드(key=60) 삽입127
4.5.4 노드(key=50) 삽입132
4.5.5 노드(key=40) 삽입136
4.5.6 노드(key=30) 삽입139
4.5.7 노드(key=20) 삽입141
4.5.8 노드(key=10) 삽입144
4.6 삽입(INSERT) 소스3 분석150
4.6.1 노드(key=10) 삽입150
4.6.2 노드(key=30) 삽입153
4.6.3 노드(key=20) 삽입156
4.6.4 노드(key=50) 삽입163
4.6.5 노드(key=40) 삽입164
4.6.6 노드(key=25, 22) 삽입167
4.6.7 노드(key=35) 삽입169
4.7 탐색(SEARCH) 소스 분석174
4.8 삭제(ERASE) 소스 분석181
4.8.1 노드(key=10) 삭제188
4.8.2 노드(key=20) 삭제192
4.8.3 노드(key=30) 삭제195
4.8.4 노드(key=40) 삭제202
4.8.5 노드(key=50) 삭제205
4.8.6 노드(key=60) 삭제211
4.8.7 노드(key=70) 삭제215
4.8.8 노드(key=80) 삭제218
5. B+TREE221
5.1 B+TREE 소스221
5.2 B+TREE 구조체247
5.3 B+TREE 삽입 알고리즘250
5.3.1 노드 분할253
5.3.2 부모노드 생성255
5.3.3 부모노드 분할259

제2부 머신러닝 알고리즘263
6. 머신러닝 알고리즘264
6.1 머신러닝 소개264
6.1 TENSORFLOW 설치269
6.2 TENSORFLOW 기본272
6.2 LINEAR REGRESSION274
6.2.1 가설과 비용함수(학습 모델)274
6.2.2 비용 줄이기(기울기 예측)276
6.2.3 미분 함수(Convex)278
6.3 LINEAR REGRESSION LEARNING281
6.3.1 단항변수 기울기 학습1281
6.3.2 단항변수 기울기 학습2282
6.3.3 단항변수 기울기 학습3284
6.3.4 다항변수 기울기 학습286
6.3.5 다항변수 매트릭스 처리289
6.3.6 다항변수 파일 읽기291
6.4 LOGISTIC(BINARY) CLASSIFICATION294
6.4.1 분류 학습294
6.4.2 비용 함수295
6.4.3 Logistic Regression297
6.5 MULTINOMIAL(SOFTMAX) CLASSIFICATION300
6.5.1 Hypothesis300
6.5.2 Softmax function301
6.5.3 Cross-Entropy Cost Function302
6.5.4 TensorFlow 실습303
7. DEEP LEARNING310
7.1 딥러닝 기본310
7.1.1 행동 함수311
7.1.2 XOR 문제312
7.1.3 Neural Network312
7.1.4 Back Propagation317
7.2 XOR 문제 해결 실습321
7.2.1 일반적인 XOR 문제321
7.2.2 XOR Neural Network323
7.2.3 XOR Deep Learning325
7.2.4 XOR Deep Learning2331
7.2.5 XOR ReLU334
7.3 딥러닝 정확성 향상337
7.3.1 ReLU337
7.3.2 Good Weight (초기값)339
7.3.3 Overfitting 조정340
7.3.4 DropOut341
7.3.4 Optimizer 성능 비교342
7.4 딥러닝 실습343
7.4.1 일반적인 softmax344
7.4.2 ReLU347
7.4.3 DropOut349
7.4.4 초기값 설정352
7.4.5 결과 정리354
8. CONVOLUTIONAL NEURAL NETWORK355
8.1 CONVOLUTION LAYER355
8.2 POOLING LAYER358
8.3 CNN 종류361
8.3.1 AlexNet361
8.3.2 GoogLeNet361
8.3.3 ResNet362
8.3.4 DeepMind AlphaGo362
8.4 CNN 실습363
8.4.1 Adam Optimizer363
8.4.2 RMS Optimizer367
8.4.3 결과 정리371
9. MOTION 분석372
9.1 MOTION 소스 빌드372
9.2 MOTION 소스 분석383

부록A. 이세돌 9단과 알파고384
A.1 경우의 수 줄이기(REDUCTION)385
A.2 학습하기 (DEEP LEARNING)387
A.3 알파고 1차 대국 정리388
A.3.1 첫번째 싸움의 시작389
A.3.2 두번째 싸움의 시작390
A.3.3 승패의 갈림길, 세번째 싸움393
A.4 알파고 2차 대국 정리396
A.4.1 초반에 흔들리는 알파고397
A.4.2 중후반부터 강해지는 알파고401

부록B. 커널연구회 교육과정 상세안내406
B.1 커널연구회 교육과정 로드맵406
B.2 C언어와 자료구조 알고리즘407
B.3 리눅스 시스템 프로그래밍411
B.4 ARM 아키텍쳐, STM32 프로그래밍415
B.5 리눅스 커널 자료구조 알고리즘 실습418
B.6 리눅스 커널 소스 디버깅 실습422
B.7 리눅스 커널 DEVICE TREE 실습426
커널연구회 교육학원 위치(약도)431

라즈베리파이 라지그 프로젝트

이용현황보기

자료구조 알고리즘 & 머신러닝 상세분석 이용현황 표 - 등록번호, 청구기호, 권별정보, 자료실, 이용여부로 구성 되어있습니다.
등록번호 청구기호 권별정보 자료실 이용여부
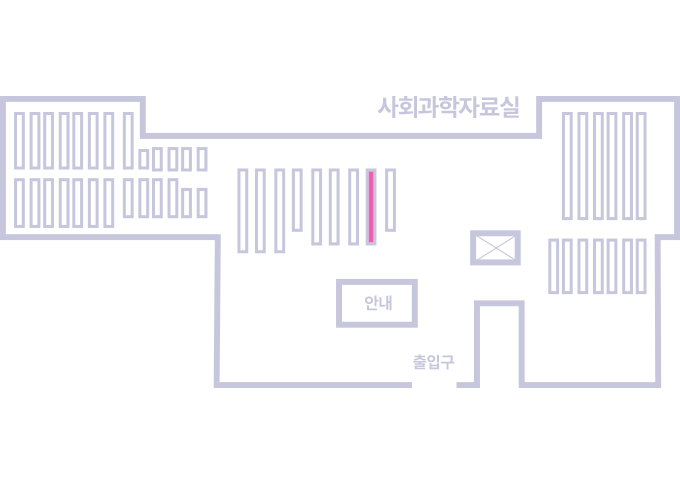
0002203453 005.73 -16-5 서울관 서고(열람신청 후 1층 대출대) 이용가능
0002203454 005.73 -16-5 서울관 서고(열람신청 후 1층 대출대) 이용가능

출판사 책소개

알라딘제공
컴퓨팅에서 자료구조와 알고리즘은 계산적인 절차이며, 자료구조는 프로그래밍 언어에서 데이터 구조(struct)로 표현되고 알고리즘은 이러한 데이터 구조에 접근하는 순서 및 회수에 해당한다. 자료구조와 알고리즘은 상호 의존적이다. 자료구조를 잘 설계하면 알고리즘 효율이 좋아진다. 알고리즘은 컴퓨터 하드웨어가 시작되기 전부터 연구되어 왔다. 그러나 현대에 이르러 컴퓨터 하드웨어 성능이 비약적으로 발전하고 많은 데이터들이 축적됨으로 인해서 알고리즘 연구가 새로운 전환기를 맞이하고 있다. 그동안 컴퓨팅 역사에서 해결하지 못하고 있었던 문제들을 머신러닝/딥러닝에서 하나씩 해결하기 시작하면서 이것에 적용된 알고리즘 학습이 중요해 졌다. 머신러닝/딥러닝은 인간의 뇌세포가 학습해 나가는 방식과 유사하게 동작한다. 이것의 원리는 매우 단순하므로 쉽고 재미있게 머신러닝/딥러닝을 학습할 수 있다. 이 책은 머신러닝을 이론적으로만 설명하는 것이 아니라 기본부터 심화 학습까지 직접 파이썬에서 TensorFlow로 직접 따라하면서 익힐 수 있도록 구성했다. 이 책은 1부와 2부로 나누어져 있는데, 머신러닝/딥러닝부터 공부하고자하는 독자분들은 2부부터 학습해도 된다. 2부에서 학습한 머신러닝 알고리즘을 직접 C언어로 구현해 보고 싶다면, 1부의 내용을 학습하면 좋을 듯 하다. 이책에 있는 모든 예제 소스들은 Github에 공개했다.

[내용 요약]
이책은 1부와 2부로 구성되어 있다. 1부는 전통적인 자료구조와 알고리즘에 대해서 C언어로 실습할 수 있도록 구성했고, 2부에서 머신러닝/딥러닝을 파이썬과 TensorFlow로 실습하면서 학습할 수 있도록 구성했다. 머신러닝/딥러닝부터 공부하고자 하는 독자분들은 1부 내용은 간략히 참조만하고 바로 2부의 내용을 학습해도 된다. 머신러닝은 가설함수(학습모델)와 비용함수를 사용하여 비용이 최소화 되는 방향으로 반복연산하면서 가중치(Weight)값을 찾아가는 알고리즘으로 구성되어 있다. 대부분 행렬(Matrix)연산을 하므로 전통적인 자료구조 알고리즘보다 쉽게 구현할 수 있다. 또한 딥러닝에서 과거에 해결하지 못했던 난제들을 어떻게 해결했는지 자세히 실습할 수 있도록 책의 내용을 구성했다. 2부의 머신러닝/딥러닝 알고리즘을 학습한후 C언어로 알고리즘을 직접 구현해보고자 한다면 1부의 내용이 많은 도움이 될듯하다. 이책에 있는 예제 소스들은 모두 Github에 공개했으니 책의 내용을 참조해 주기 바란다.